Lancé officiellement le 12 novembre 2026 par Google DeepMind, Gemini 4 Hydrogen (gemini-4-hydrogen) redéfinit l'équilibre économique des architectures agentiques. Alors que Gemini 4 Argon (octobre 2026) et Gemini 4 Carbon (10 novembre 2026) ciblent le raisonnement scientifique et architectural au long cours, Hydrogen prend la relève de Gemini 3.8 Flash comme moteur d'exécution rapide au quotidien — sans pour autant faire figure de « petit modèle ». Avec un score de 51 sur l'Artificial Analysis Intelligence Index en réglage par défaut (dépassant Argon qui plafonne à 50) et un débit record de 236 tokens/seconde, ce modèle bouscule la hiérarchie établie.
Voici notre analyse technique complète : spécifications de la Model Card officielle, décryptage des benchmarks indépendants, grille tarifaire, cost per task réel et retours d'essais sur des workflows d'ingénierie data et d'agents.
1. Fiche technique et architecture de Gemini 4 Hydrogen
Selon la Model Card officielle publiée par Google DeepMind, Gemini 4 Hydrogen est un modèle propriétaire à poids fermés directement adapté de Gemini 4 Carbon (le modèle le plus puissant de la gamme). Google n'en divulgue pas le nombre de paramètres, mais expose des caractéristiques techniques taillées pour les boucles d'agents intensives :
- Identifiant API stable dès le lancement :
gemini-4-hydrogen(disponible sur Gemini API, Google AI Studio avec un palier gratuit soumis à limites de débit, Gemini Enterprise, Google Search, Sheets et Google Antigravity). - Fenêtre de contexte unifiée de 1 048 576 tokens (1M) : l'entrée, les tokens de réflexion internes (thinking) et la sortie partagent cette même enveloppe d'un million de tokens.
- Plafond de génération : jusqu'à 65 536 tokens (64K) en réponse synchrone standard, et jusqu'à 1M de tokens via le décodage long asynchrone en arrière-plan.
- Modalités prises en charge : texte, images, audio, vidéo, PDF complexes, tableaux et graphiques en entrée ; sortie textuelle et structurée (JSON / appels d'outils).
- Date de coupure des connaissances (knowledge cutoff) : mars 2026.
Les 4 niveaux de réflexion (thinking_level) et points d'attention API
Contrairement à Gemini 3.8 Flash dont le niveau par défaut était medium, Hydrogen adopte high comme réglage par défaut parmi quatre paliers configurables dans generation_config : low, medium, high et un nouveau palier xhigh. Trois changements cassants sont à anticiper lors d'une migration de code existant :
- La valeur historique
minimaldéclenche désormais une erreur API. - Les hyperparamètres classiques
temperature,top_pettop_ksont ignorés côté serveur afin de préserver la calibration des chaînes de raisonnement. - Le cache explicite (
cached_content) disparaît au profit d'un cache implicite automatique activé dès qu'un préfixe de prompt atteint 4 096 tokens, facturé avec 95 % de remise (0,075 $/ 1M tokens).
2. Analyse des benchmarks : où Hydrogen excelle et où la concurrence résiste
En croisant les mesures indépendantes d'Artificial Analysis, de Vals AI et la table d'évaluation de Google DeepMind face à Claude Sonnet 5.5 et GPT-6.1 Terra, le profil technique du modèle apparaît très nettement :
| Benchmark / Métrique | Gemini 4 Hydrogen | Gemini 3.8 Flash | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|---|
| Artificial Analysis Index | 51 (high) / 54 (xhigh) | 31 | 55 (max) | 51 (max) |
| Vitesse de génération | 236 tok/s (high) / 198 (xhigh) | 111 tok/s | 144 tok/s | 70 tok/s |
| Terminal-Bench 4.1 (code & CLI) | 57,0 % | 18,2 % | 63,9 % | Non publié |
| SWE-sweep (maintenance dépôt) | 13,5 % | — | 3,1 % | 5,8 % |
| AutomationBench-AA | 76,1 % | — | 71,8 % | 60,2 % |
| Agents' Last Exam v1.1 | 71,6 % | — | 60,4 % | 69,8 % |
| OSWorld-2.1 (ordinateur) | 77,6 % | — | 83,9 % | 74,2 % |
| HLE-Diamond | 58,8 % | — | 53,3 % | 47,3 % |
| Vals Tax Agent / Legal Research | 52,3 % (#1) / 55,8 % (#1 ex aequo) | — | — | — |
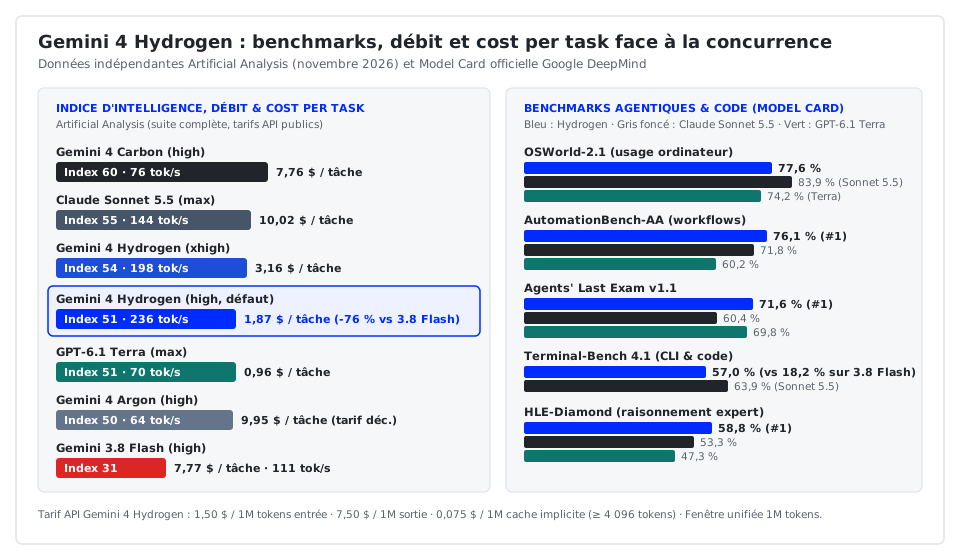
Ce qu'il faut retenir des chiffres : le bond générationnel face à Gemini 3.8 Flash est spectaculaire (+20 points d'indice d'intelligence et un score plus que triplé sur Terminal-Bench 4.1, passant de 18,2 % à 57,0 %). Hydrogen domine les tâches d'automatisation métier (AutomationBench-AA à 76,1 %), la lecture multimodale de graphiques (Chartography à 66,6 %) et la recherche fiscale/juridique sur Vals AI. En revanche, Claude Sonnet 5.5 conserve l'avantage pur en ingénierie système sur terminal (63,9 %) et en manipulation d'interface graphique (OSWorld-2.1 à 83,9 %).
3. Prix API et paradoxe du cost per task : 2× plus cher au token, 4× moins cher à la tâche
Sur le papier, la grille tarifaire publique de Gemini 4 Hydrogen est deux fois plus élevée que le tarif de lancement 2026 de Gemini 3.8 Flash :
- Entrée (input) : 1,50 $ / million de tokens (tarif plat jusqu'à 1M de tokens).
- Sortie + réflexion (output) : 7,50 $ / million de tokens.
- Cache implicite (≥ 4 096 tokens) : 0,075 $ / million de tokens (-95 %).
- Mode Batch asynchrone : 0,75 $ / 1M en entrée et 3,75 $ / 1M en sortie.
À noter que Google a déjà annoncé l'alignement tarifaire de Gemini 3.8 Flash à 1,50 $ / 7,50 $ au 1er janvier 2027, tandis que Gemini 4 Argon et Carbon passent à 4,00 $ / 20,00 $ au 1er décembre 2026.
Mais comme nous le démontrions dans notre étude sur le cost per task des modèles IA, le prix au token est un indicateur trompeur. Sur l'exécution complète de la suite Intelligence Index, Artificial Analysis a mesuré une dépense réelle de 1,87 $ par tâche d'indice pour Gemini 4 Hydrogen (high), contre 7,77 $ pour Gemini 3.8 Flash et 9,95 $ pour Gemini 4 Argon !
Pourquoi un modèle deux fois plus cher au token coûte-t-il 76 % moins cher à l'arrivée que 3.8 Flash ? Parce qu'Hydrogen génère 12 à 23 % de tokens inutiles en moins, résout les problèmes dès la première passe sans boucler sur des erreurs d'outils, et termine ses exécutions 2,5 fois plus vite. Attention toutefois au mode xhigh : très verbeux en réflexion interne, il fait grimper la facture à 3,16 $ pour un gain marginal de 3 points d'indice (54 vs 51). De son côté, GPT-6.1 Terra égalise le score de 51 pour environ moitié moins cher par tâche (0,96 $), mais avec un débit trois fois plus lent (70 tok/s contre 236 tok/s).
4. Essais pratiques et retour terrain sur nos architectures d'agents
Testé sur trois scénarios représentatifs de nos projets AI Engineering et Google Cloud :
- Boucles d'agents MCP et SQL analytique (BigQuery / Snowflake) : en réglage
high, la latence perçue chute drastiquement grâce aux ~236 tokens/s. Surtout, l'amélioration majeure concerne l'honnêteté agentique : Google rapporte 5× moins d'affirmations inventées que sur 3.8 Flash (96,7 % de conformité interne) et une résistance 2,3× supérieure à l'injection de prompt indirecte. Concrètement, lorsqu'une colonne manque dans un schéma SQL, Hydrogen signale l'ambiguïté au lieu d'inventer un champ inexistant. - Extraction multimodale de liasses PDF et graphiques financiers : la combinaison de la fenêtre de 1M de tokens à tarif plat et du cache implicite à 0,075 $/1M rend l'interrogation répétée de gros dossiers techniques imbattable économiquement dès la deuxième question sur le même document. Seul bémol relevé et confirmé dans la section Safety de la Model Card (+5,57 points de sur-refus) : sur certaines images de documents administratifs flous ou sensibles, le filtre de sécurité multimodal se montre parfois excessivement prudent.
- Orchestration hybride Carbon + Hydrogen : reproduire le pattern Orchestrator de Google Antigravity — confier le plan d'architecture initial à Gemini 4 Carbon, puis déléguer toutes les éditions de code, appels MCP et validations unitaires à Gemini 4 Hydrogen en
mediumouhigh— permet d'approcher la qualité maximale de Carbon tout en réduisant le budget de tokens de 25 % à 60 %.
Verdict technique : faut-il migrer vers Gemini 4 Hydrogen ?
Oui, immédiatement si vous utilisiez Gemini 3.8 Flash ou Gemini 4 Argon pour des workflows d'agents, du RAG multimodal ou de l'extraction structurée. Vous obtenez une intelligence supérieure à Argon, une vitesse 2,5× plus élevée et un cost per task divisé par quatre. Réservez xhigh, Gemini 4 Carbon ou Claude Sonnet 5.5 aux tâches d'architecture logicielle critique et de débogage terminal profond.
Sources officielles et benchmarks
- Google DeepMind — Gemini 4 Hydrogen Official Model Card (12 novembre 2026)
- Artificial Analysis — Gemini 4 Hydrogen Intelligence Index, Speed & Cost
- Vals AI — Gemini 4 Hydrogen Enterprise Benchmarks (Tax, Legal, Vibe Code)
- Google AI Studio — Gemini API Pricing & Implicit Caching Documentation
Vous souhaitez intégrer Gemini 4 Hydrogen ou mettre en place un routage multi-modèles optimisé en cost per task au sein de 21brain ou sur votre infrastructure GCP ? Planifiez un échange technique avec 21datas ou contactez notre équipe.
in Data