Faire tourner un grand modèle de langage (open-weights) chez soi ou au bureau séduit autant les développeurs que les PME suisses attachées à la confidentialité absolue de leurs données. Mais entre les annonces marketing et la réalité physique du bus mémoire d'une carte graphique, les déconvenues sont fréquentes : un modèle dit « léger » sature brutalement 16 Go de VRAM dès qu'on lui soumet un PDF de vingt pages, tandis qu'un géant Mixture-of-Experts (MoE) annoncé avec « seulement 3,3 milliards de paramètres actifs » refuse tout net de démarrer sur un PC portable.
Voici le guide technique complet et vérifié pour fin 2026 : combien de VRAM exigent réellement les modèles open source de pointe, ce qu'un PC gaming moyenne gamme ou haut de gamme peut réellement encaisser, quelles alternatives installer à la maison au-delà de 32 Go, et combien coûte l'électricité en francs suisses (CHF) au tarif officiel de l'ElCom.
1. La vraie formule de calcul de la VRAM (et le piège fréquent des modèles MoE)
Pour qu'un LLM génère du texte de manière fluide sans s'effondrer à 1 ou 2 tokens par seconde sur la RAM processeur, trois éléments doivent tenir simultanément dans la mémoire vidéo (VRAM) :
VRAM totale (Go) ≈ (Paramètres totaux en milliards × (Bits / 8) × 1,12) + Cache KV (contexte) + Overhead moteur (0,8 à 1,5 Go)
Le facteur 1,12 couvre les métadonnées d'échelle des quantifications modernes (GGUF Q4_K_M ou MXFP4) et les couches d'attention conservées en plus haute précision. Surtout, ne confondez jamais paramètres totaux et paramètres actifs dans un modèle Mixture-of-Experts (MoE) :
- Les paramètres totaux dictent la VRAM obligatoire : tous les experts doivent rester chargés en mémoire vive car chaque nouveau token peut activer un expert différent.
- Les paramètres actifs dictent le débit (tokens/s) et la consommation électrique par token : un
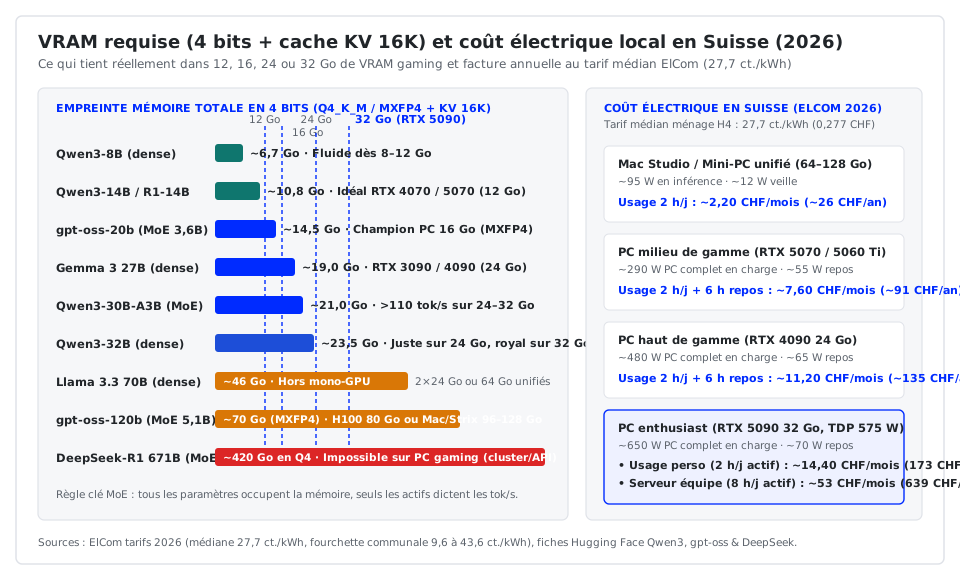
Qwen3-30B-A3Boccupe ~21 Go de mémoire comme un 30B classique, mais calcule chaque mot aussi vite et sobrement qu'un petit modèle de 3,3B !
N'oubliez pas non plus le cache KV (Key-Value cache) qui croît linéairement avec la longueur de conversation : passer d'un contexte de 4 096 tokens à 32 768 ou 65 536 tokens ajoute facilement 2 à 6 Go de VRAM supplémentaires (qu'il est conseillé de quantifier en q8_0 dans Ollama ou llama.cpp).
2. Tableau de la VRAM requise pour les modèles open source de référence (2026)
| Modèle open-weights | Architecture (total / actif) | Poids en FP16 | VRAM réelle en 4 bits (Q4_K_M / MXFP4 + KV 16K) | Matériel minimal fluide |
|---|---|---|---|---|
| Qwen3-8B / R1-Distill-8B | Dense (8,2B) | ~16,5 Go | ~6,7 Go | GPU 8 Go à 12 Go |
| Qwen3-14B / R1-Distill-14B | Dense (14,8B) | ~29,6 Go | ~10,8 Go | RTX 3060 / 4070 / 5070 (12 Go) |
| openai/gpt-oss-20b | MoE (21B / 3,6B actifs) | MXFP4 natif | ~14,5 Go | GPU 16 Go (RTX 4060 Ti / 5060 Ti / 5080) |
| Gemma 3 27B / Mistral Small 24B | Dense (24B – 27B) | ~48 – 54 Go | ~18,0 – 19,5 Go | RTX 3090 / 4090 / RX 7900 XTX (24 Go) |
| Qwen3-30B-A3B | MoE (30,5B / 3,3B actifs) | ~61 Go | ~21,0 Go | GPU 24 Go (>110 tok/s) ou 32 Go |
| Qwen3-32B | Dense (32,8B) | ~65,6 Go | ~23,5 Go (16K) / ~26 Go (64K) | Juste sur 24 Go · Idéal RTX 5090 (32 Go) |
| Llama 3.3 70B Instruct | Dense (70,6B) | ~141 Go | ~46,0 Go | 2× GPU 24 Go ou 64 Go mémoire unifiée |
| openai/gpt-oss-120b | MoE (117B / 5,1B actifs) | MXFP4 natif | ~70,0 Go | 1× H100 80 Go ou 96–128 Go unifiés |
| Qwen3-235B-A22B | MoE (235B / 22B actifs) | ~470 Go | ~148 Go | Mac Studio 192 Go+ ou serveur multi-GPU |
| DeepSeek-R1 / V3 (complet) | MoE (671B / 37B actifs) | ~1 340 Go | ~420 Go | Cluster serveur uniquement (ou API) |
3. PC gaming moyenne gamme vs haut de gamme : que peut-on vraiment installer à la maison ?
Sur un PC gaming moyenne gamme (12 Go à 16 Go de VRAM)
- Palier 12 Go (RTX 4070, RTX 4070 Super, RTX 5070, RTX 3060 12 Go) : vous hébergez confortablement Qwen3-8B en précision quasi sans perte (
Q8_0), ou Qwen3-14B / DeepSeek-R1-Distill-14B enQ4_K_Mavec 8K à 16K de contexte (~45 à 65 tokens/s). C'est amplement suffisant pour de la rédaction confidentielle, du résumé de courriers et de l'assistance au code locale, mais trop étroit pour des agents multi-étapes complexes. - Palier 16 Go (RTX 5060 Ti 16 Go, RTX 4070 Ti Super, RTX 5080, RX 7800 XT) : c'est le véritable ticket d'entrée sérieux à budget maîtrisé en 2026, notamment grâce à
openai/gpt-oss-20b(publié sous licence Apache 2.0 et post-entraîné nativement en MXFP4), qui tient dans 16 Go tout en n'activant que 3,6B de paramètres par token.
Sur un PC gaming haut de gamme (24 Go à 32 Go de VRAM)
- Palier 24 Go (RTX 3090 d'occasion, RTX 4090, Radeon RX 7900 XTX) : le rapport performance/prix roi en local.
Qwen3-30B-A3By délivre plus de 110 tokens/s avec son mode de réflexion activable à la demande (/thinkou/no_think), et Gemma 3 27B ajoute la vision multimodale sur documents. Qwen3-32B dense y rentre enQ4_K_M, mais avec une marge de contexte serrée (8K–16K). - Palier 32 Go (NVIDIA GeForce RTX 5090) : avec ses 32 Go de GDDR7 et sa bande passante mémoire massive (~1,79 To/s), la RTX 5090 permet enfin d'exploiter Qwen3-32B avec 64K de contexte ou en quantification supérieure
Q6_Ksans aucun ralentissement. En revanche, soyons transparents : même une RTX 5090 à 32 Go ne peut pas loger un modèle 70B dense nigpt-oss-120bintégralement en VRAM sans déborder sur la RAM système DDR5 (ce qui fait chuter le débit sous les 5 à 8 tokens/s sur un modèle dense).
L'astuce à domicile pour dépasser 32 Go sans salle serveur : la mémoire unifiée
Si votre objectif domestique ou PME est d'exécuter de gros modèles MoE comme gpt-oss-120b (~70 Go) ou Qwen3-235B-A22B (~148 Go), la solution la plus silencieuse et réaliste à la maison n'est pas un PC gaming énergivore, mais une machine à mémoire unifiée haute bande passante : un Mac Studio (M2/M3/M4 Max ou Ultra avec 96 à 192 Go) ou un mini-PC AMD Ryzen AI Max+ 395 (« Strix Halo », 128 Go LPDDR5X). Comme ces modèles MoE ne lisent que 5B à 22B de poids par token, ils y tournent à une vitesse très confortable (20 à 45 tokens/s) pour moins de 110 watts ! L'alternative PC consiste à monter deux RTX 3090 d'occasion (48 Go de VRAM cumulés) dans un boîtier grand tour bien ventilé avec une alimentation de 1 200 W.
4. Consommation des modèles et facture électrique estimée en Suisse (tarif ElCom 2026)
Selon les données officielles de la Commission fédérale de l'électricité (ElCom), le tarif médian de l'électricité en Suisse en 2026 pour un ménage type (profil H4, 4 500 kWh/an) s'établit à 27,7 centimes par kWh (0,277 CHF/kWh) — en baisse d'environ 4 % par rapport aux 29,0 ct./kWh de 2025, avec d'importants écarts communaux (de ~9,6 ct./kWh dans certaines communes alpines jusqu'à ~43,6 ct./kWh).
Voici ce que consomme réellement un poste d'IA local à la prise en Suisse :
| Configuration matérielle locale | Puissance à la prise (inférence / veille) | Usage individuel (2 h/j actif + 6 h veille) | Serveur PME (8 h/j actif + 16 h veille) | Énergie pour 1M tokens générés |
|---|---|---|---|---|
| Mac Studio / Mini-PC unifié 128 Go (ex. gpt-oss-120b ou Qwen3-30B-A3B) | ~95 W / ~12 W | ~8,0 kWh/mois ~2,20 CHF/mois (~26 CHF/an) | ~31,7 kWh/mois ~8,80 CHF/mois (~105 CHF/an) | ~0,65 à 1,20 kWh (0,18 à 0,33 CHF) |
| PC gaming milieu de gamme (RTX 5070 12 Go / 5060 Ti 16 Go) | ~290 W / ~55 W | ~27,7 kWh/mois ~7,65 CHF/mois (~92 CHF/an) | ~97,3 kWh/mois ~27,00 CHF/mois (~324 CHF/an) | ~1,20 à 1,60 kWh (0,33 à 0,44 CHF) |
| PC gaming haut de gamme (RTX 4090 24 Go) | ~480 W / ~65 W | ~41,1 kWh/mois ~11,40 CHF/mois (~136 CHF/an) | ~148,4 kWh/mois ~41,10 CHF/mois (~493 CHF/an) | MoE : ~0,90 kWh (0,25 CHF) Dense 32B : ~3,5 kWh (0,97 CHF) |
| PC enthusiast extrême (RTX 5090 32 Go, TDP GPU 575 W) | ~650 W / ~70 W | ~52,3 kWh/mois ~14,50 CHF/mois (~174 CHF/an) | ~192,2 kWh/mois ~53,25 CHF/mois (~639 CHF/an) | MoE : ~0,95 kWh (0,26 CHF) Dense 32B : ~3,8 kWh (1,05 CHF) |
Deux enseignements énergétiques majeurs ressortent de ce calcul :
- L'architecture MoE divise la facture électrique par trois ou quatre à intelligence comparable : sur une même RTX 4090, générer un million de tokens avec
Qwen3-30B-A3B(~130 tok/s) ne coûte qu'environ 0,25 CHF d'électricité, contre près de 1,00 CHF avec un modèle 32B dense trois fois plus lent à calculer chaque mot. - En usage ponctuel, ce n'est jamais l'électricité suisse qui ruine le ROI, mais l'amortissement du matériel : 14,50 CHF d'électricité par mois sur une RTX 5090 est négligeable face à une machine à 3 500–4 500 CHF. En dessous de 15 à 20 millions de tokens traités par mois, une API cloud gouvernée en région Zurich ou un routage hybride reste financièrement plus rentable ; au-delà — ou lorsque le secret professionnel interdit tout transit externe — l'hébergement local amortit son matériel en 12 à 18 mois.
Sources et références techniques
- ElCom (Commission fédérale de l'électricité) — Prix de l'électricité en Suisse 2026 (médiane 27,7 ct./kWh)
- OpenAI — Fiche modèle officielle
gpt-oss-120b&gpt-oss-20b(MXFP4, Apache 2.0) - Qwen Team — Documentation officielle
Qwen3-30B-A3B& gamme Qwen3 - llama.cpp / GGML — Quantification GGUF et calcul du cache KV
Vous hésitez entre un serveur d'inférence privé on-premise en Suisse, un déploiement souverain sur Google Cloud Zurich ou une architecture hybride dans 21brain ? Échangez avec nos ingénieurs AI & Data ou contactez 21datas pour dimensionner votre infrastructure au franc près.
in Data