Choisir un grand modèle de langage (LLM) pour une application d'entreprise en se basant uniquement sur le tarif affiché par million de tokens est l'une des erreurs financières les plus fréquentes en 2026. Entre les modèles à raisonnement étendu qui génèrent dix fois plus de tokens cachés, les modèles économiques qui échouent au premier appel d'outil et imposent trois relances successives, et les architectures capables de tirer parti du cache de prompt, l'écart entre le prix catalogue et la facture réelle en production dépasse régulièrement 300 %.
Pour identifier quels modèles IA offrent réellement le meilleur rapport qualité-prix, les équipes d'ingénierie data et FinOps s'appuient désormais sur une métrique centrale : le cost per task (coût complet par tâche résolue), popularisée par les travaux d'Artificial Analysis, croisée avec les évaluations humaines à l'aveugle de Arena.ai (LMArena) et les analyses macroéconomiques du Stanford AI Index.
Pourquoi le prix par million de tokens ne suffit plus pour évaluer la rentabilité d'un modèle IA
Pendant longtemps, les directions techniques comparaient les API de modèles IA à l'aide d'un tableau simple : combien coûtent un million de tokens en entrée (input) et un million de tokens en sortie (output) ? Cette approche fonctionnait lorsque les modèles produisaient des réponses de longueur quasi identique en un seul appel. Avec l'essor des modèles de raisonnement (reasoning models) et des workflows agentiques multi-étapes, cette métrique unitaire est devenue trompeuse pour quatre raisons fondamentales :
- L'inflation des tokens de réflexion internes (
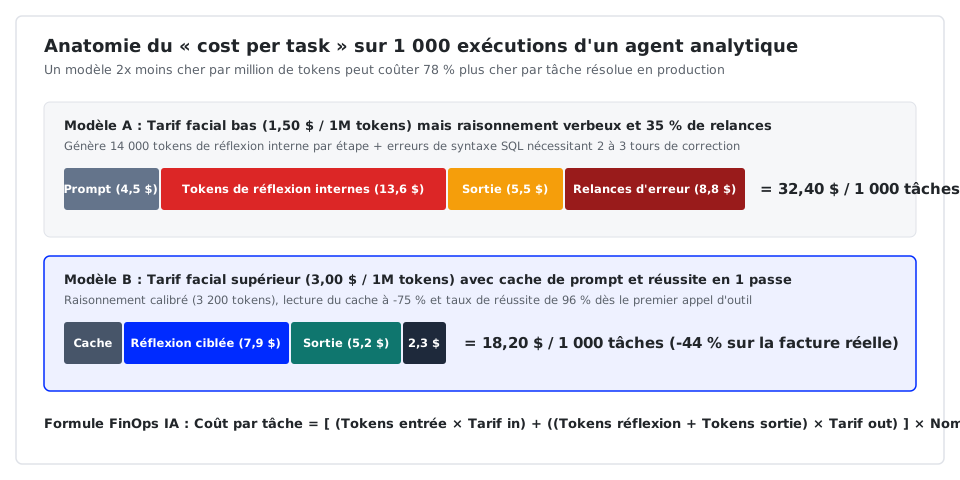
reasoning tokens) : Lorsqu'un modèle décompose un problème complexe avant de formuler sa réponse finale, l'ensemble des tokens de chaîne de pensée est facturé au tarif des tokens de sortie (souvent quatre à cinq fois plus élevé que le tarif d'entrée). Un modèle facturé 1,50 $ par million de tokens de sortie qui consomme 14 000 tokens de réflexion interne revient plus cher qu'un modèle facturé 4,00 $ qui résout le même problème en 2 500 tokens. - Le taux de réussite au premier essai (
first-pass success rate) : Dans une architecture d'agent IA connectée à un entrepôt Snowflake ou BigQuery ou à un ERP, une erreur de syntaxe SQL ou un schéma JSON mal formé déclenche une boucle d'auto-correction. Chaque relance renvoie l'intégralité du contexte système, de l'historique et de la trace d'erreur. - L'efficacité du cache de contexte (
prompt caching) : Les fournisseurs proposent des remises de 50 % à 90 % sur les préfixes de prompts mis en cache. Selon la stabilité du prompt système et la fenêtre de rétention du cache, le coût effectif d'entrée varie drastiquement. - La densité sémantique et la concision : Certains modèles sont structurellement verbeux, ce qui augmente simultanément la facture de sortie et la latence perçue par l'utilisateur final.
Qu'est-ce que le cost per task et comment est-il mesuré par Artificial Analysis ?
Le cost per task mesure le montant total en dollars nécessaire pour accomplir avec succès un ensemble standardisé de tâches représentatives (génération et débogage de code, raisonnement mathématique et financier, synthèse documentaire, extraction structurée et appels d'outils). Dans la méthodologie d'Artificial Analysis, chaque modèle exécute l'intégralité de la suite composant l'Intelligence Index (qui agrège des évaluations exigeantes telles que MMLU-Pro, GPQA Diamond, LiveCodeBench, SciCode et des tests d'instruction).
Le calcul comptabilise le volume exact de tokens d'entrée envoyés, la totalité des tokens de raisonnement générés et les tokens de réponse finale produits pour parvenir à la solution, multipliés par la grille tarifaire officielle de l'API. On obtient ainsi l'équation économique réelle d'un déploiement en production :
Cost per task = [ (Tokens entrée × Prix_in) + ((Tokens réflexion + Tokens sortie) × Prix_out) ] × (1 / Taux de succès en 1 passe)
Ce changement de perspective transforme immédiatement la hiérarchie des modèles. Un modèle d'entrée de gamme qui affiche un tarif facial dérisoire mais plafonne à 62 % de fiabilité sur de la génération SQL impose des vérifications et des ré-exécutions qui détruisent son avantage tarifaire initial.
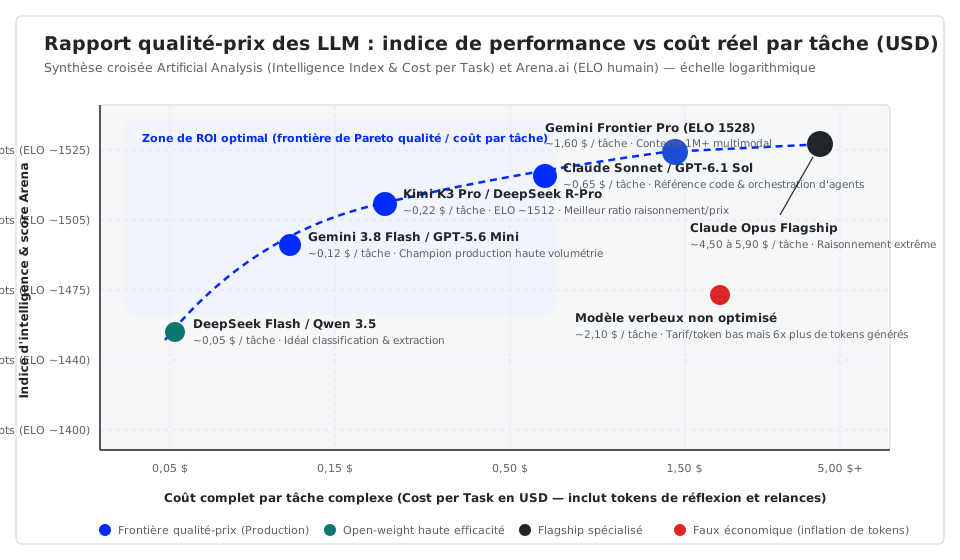
Comparatif 2026 des modèles IA selon le cost per task et le score ELO Arena.ai
En croisant l'Intelligence Index et le Cost per Task d'Artificial Analysis avec le classement ELO de Arena.ai (basé sur plus de six millions de duels aveugles votés par des utilisateurs humains), quatre segments distincts se dessinent sur la frontière de Pareto :
| Modèle / Famille | Catégorie | Score Arena.ai (ELO approx.) | Indice d'intelligence | Cost per task moyen (suite complète) | Cas d'usage au meilleur ROI |
|---|---|---|---|---|---|
| Gemini 3.8 Flash / Flash-Lite | Propriétaire rapide | ~1485 – 1500 | 48 – 52 | 0,08 $ – 0,15 $ | Routage d'agents, RAG haute volumétrie, extraction documentaire |
| DeepSeek R-Pro / Kimi K3 | Open-weight raisonnement | ~1505 – 1515 | 53 – 56 | 0,18 $ – 0,35 $ | Analyse analytique, génération SQL/Python à fort volume |
| Qwen 3.5 / DeepSeek Flash | Open-weight économique | ~1450 – 1480 | 42 – 46 | 0,03 $ – 0,08 $ | Classification, étiquetage, résumé de tickets, pré-filtrage |
| Claude Sonnet / GPT-6.1 Sol | Frontière équilibrée | ~1515 – 1522 | 55 – 58 | 0,55 $ – 0,95 $ | Orchestration multi-agent complexe, ingénierie logicielle |
| Gemini Frontier Pro (High) | Frontière multimodale | ~1525 – 1530 | 58 – 60 | 1,40 $ – 2,10 $ | Synthèse de corpus massifs (1M tokens), audit multimodal |
| Claude Opus Flagship | Frontière maximale | ~1515 – 1525 | 59 – 61 | 4,20 $ – 5,98 $ | Architecture critique, arbitrage juridique et revue de code complexe |
1. Les champions de la production à grande échelle : la gamme Flash et Mini
Pour 80 % des flux opérationnels d'une PME ou d'une grande entreprise suisse, les modèles de la classe Gemini Flash et GPT Mini occupent le point d'équilibre idéal. Leur coût par tâche se situe autour de 0,10 $ à 0,15 $ sur les suites d'évaluation complètes, soit moins d'un dixième de centime par interaction unitaire en production, tout en maintenant une vitesse supérieure à 150 tokens par seconde et une excellente maîtrise du tool calling.
2. La percée des modèles open-weight sur le raisonnement : Kimi, DeepSeek et Qwen
Comme le souligne le rapport annuel du Stanford AI Index, l'écart de performance entre les modèles fermés et les modèles à poids ouverts (open-weight) s'est réduit à quelques points d'indice tout en offrant une décote tarifaire de 60 % à 85 %. Des modèles comme Kimi K3, DeepSeek ou Qwen 3.5 affichent désormais un cost per task inférieur à 0,30 $ pour un niveau de raisonnement rivalisant avec les modèles propriétaires de premier plan. Ils constituent un levier majeur pour les entreprises soucieuses de souveraineté ou d'optimisation FinOps.
3. Les modèles frontières (Sonnet, Sol, Opus) : quand payer plus réduit le coût global
Sur des tâches d'ingénierie logicielle évaluées par SWE-bench ou sur la coordination d'un système multi-agent complexe, les modèles comme Claude Sonnet ou GPT-6.1 Sol affichent un coût facial par token plus élevé, mais leur taux de réussite dès la première passe réduit le nombre d'étapes de l'agent. En revanche, les modèles ultra-flagships comme Claude Opus (jusqu'à près de 6 $ sur la suite complète de benchmarks de raisonnement intensif) doivent être réservés aux tâches à très forte valeur ajoutée unitaire où les derniers pourcents de précision justifient l'investissement.
La stratégie FinOps recommandée : le routage hybride par complexité de tâche
L'enseignement majeur des données d'Artificial Analysis et d'Arena.ai est qu'aucun modèle unique ne détient le meilleur rapport qualité-prix sur la totalité du spectre métier. Déployer un modèle flagship sur 100 % des requêtes gaspille jusqu'à 80 % du budget IA ; inversement, imposer un micro-modèle partout dégrade la confiance des utilisateurs métiers.
Chez 21datas, nous implémentons dans nos architectures AI Engineering et au sein de 21brain un routeur sémantique à deux niveaux :
- Un agent routeur léger et ultra-rapide (de classe Flash ou open-weight compact) qualifie l'intention, extrait les paramètres et traite directement les tâches de niveau 1 (recherche documentaire simple, formatage, FAQ métier) pour une fraction de centime.
- Une escalade ciblée vers un modèle de raisonnement frontière uniquement lorsque la requête exige une jointure analytique multi-domaines, un arbitrage complexe ou la génération d'un plan d'action critique.
Vous souhaitez auditer la consommation de vos agents IA ou sélectionner l'architecture offrant le meilleur coût par tâche pour vos équipes ? Prenez rendez-vous avec nos ingénieurs ou contactez-nous pour un chiffrage sur vos propres données.
in Data