Avec plusieurs centaines de modèles de langage (LLM) propriétaires et open-weight disponibles sur le marché, choisir le bon moteur pour un projet d'entreprise ne peut plus reposer sur les annonces marketing des éditeurs. Chaque fournisseur publie à chaque lancement un graphique où son modèle devance tous ses concurrents sur un sous-ensemble de tests soigneusement sélectionnés.
Pour évaluer objectivement la qualité de raisonnement, la fiabilité du code généré, la vitesse d'inférence et le coût réel en production, les architectes AI Engineering croisent les données de sept plateformes indépendantes de référence. Voici le guide complet des meilleurs sites de comparaison pour choisir vos modèles IA en 2026.
1. Arena.ai / LMArena (LMSYS Chatbot Arena) : la référence de la préférence humaine à l'aveugle
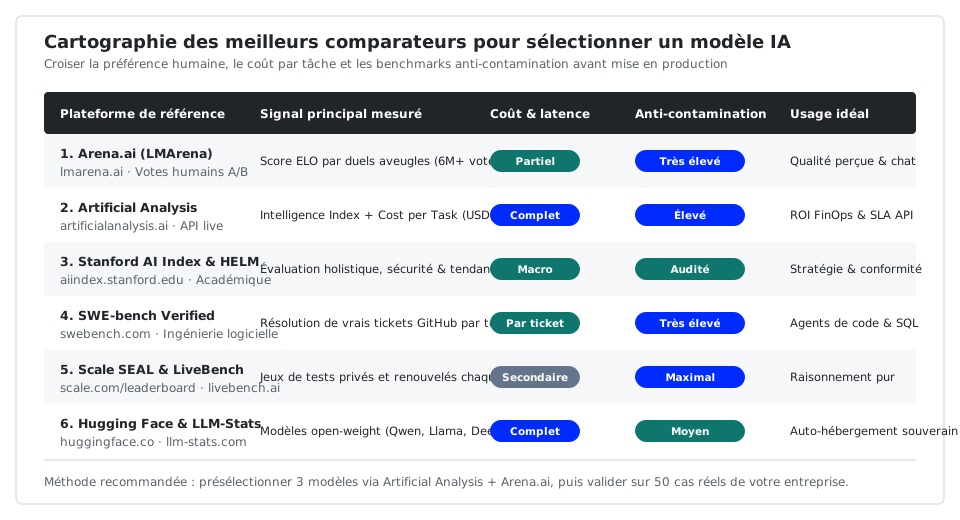
Initié par les chercheurs de UC Berkeley (LMSYS), Arena.ai (LMArena) est le comparateur participatif le plus consulté au monde, fort de plus de six millions de votes humains. Son principe repose sur un test A/B strictement aveugle : l'utilisateur soumet un prompt réel, deux modèles anonymes génèrent chacun une réponse côte à côte, et l'utilisateur vote pour la meilleure sortie avant que l'identité des modèles ne soit dévoilée.
- Ce qu'il mesure le mieux : Le score ELO (calculé via le modèle statistique de Bradley-Terry) reflète fidèlement la qualité perçue en interaction humaine, avec des classements dédiés par spécialité : Coding, Hard Prompts, Math, Vision, WebDev et * Français / Multilingue*.
- Ses limites à connaître : Les votants humains peuvent être influencés par la mise en forme (réponses longues, listes à puces bien présentées). C'est pourquoi Arena.ai propose l'option cruciale Style Control, qu'il faut systématiquement activer pour neutraliser le biais de longueur et de formatage.
2. Artificial Analysis : le juge de paix du coût par tâche, de la latence et des API
Là où Arena.ai évalue la préférence humaine, Artificial Analysis teste en continu les API de modèles et les hébergeurs d'inférence dans des conditions réelles de production. C'est l'outil indispensable des décideurs techniques et FinOps.
- Ce qu'il mesure le mieux : L'Intelligence Index (moyenne pondérée de benchmarks de raisonnement, de sciences et de code), le Cost per Task (coût complet en dollars pour résoudre la suite d'évaluation en tenant compte de la verbosité et des tokens de réflexion), le débit en tokens par seconde (
output speed) et le temps jusqu'au premier token (TTFT). - Pourquoi il est unique : Pour un même modèle open-weight (comme Llama, DeepSeek ou Qwen), Artificial Analysis compare également les différents fournisseurs cloud (Vertex AI, AWS Bedrock, Snowflake Cortex, Together, Fireworks, Groq) afin d'identifier quel hébergeur offre la meilleure vitesse au coût le plus bas.
3. Stanford Artificial Intelligence Index (HAI) & HELM : la rigueur scientifique et macroéconomique
Piloté par le Human-Centered AI Institute (HAI) de l'Université de Stanford, le portail Artificial Intelligence Index et son cadre d'évaluation technique HELM (Holistic Evaluation of Language Models) constituent la référence académique mondiale.
- Ce qu'il mesure le mieux : Une évaluation multidimensionnelle qui ne se limite pas à la précision brute, mais audite la calibration, la robustesse face aux perturbations, les biais, la sécurité, l'empreinte énergétique et l'évolution historique des coûts d'entraînement et d'inférence.
- Quand l'utiliser : Pour bâtir une stratégie IA pluriannuelle, documenter un dossier de gouvernance ou appuyer un cadrage de gouvernance des données et conformité auprès d'un comité de direction.
4. SWE-bench (Verified & Multimodal) : le vrai test pour le code et les agents autonomes
Les anciens tests de programmation comme HumanEval (quelques lignes de Python isolées) sont aujourd'hui saturés à plus de 95 %. Créé par des chercheurs de Princeton, SWE-bench évalue les modèles sur un défi autrement plus réaliste : résoudre de véritables issues GitHub issues de dépôts open-source complexes.
- Ce qu'il mesure le mieux : La capacité d'un modèle associé à un échafaudage d'agent (scaffold) à explorer une base de code multi-fichiers, reproduire un bug, éditer le code source et faire passer la suite de tests unitaires officielle (
SWE-bench Verified). - Pourquoi le consulter : Si vous sélectionnez un LLM pour assister vos équipes Data Engineering, générer des modèles dbt/SQL complexes ou orchestrer des agents d'automatisation, le score SWE-bench Verified est bien plus prédictif qu'un score de chat généraliste.
5. Scale SEAL Leaderboards et LiveBench : l'arme contre la contamination des benchmarks
Le fléau majeur des classements publics est la contamination des données d'entraînement (benchmark leakage) : lorsqu'un jeu de questions-réponses est public sur Internet, il finit inévitablement dans le corpus d'entraînement des nouvelles générations de modèles, faussant les scores.
Deux plateformes résolvent ce problème :
- Scale SEAL Leaderboards : Les évaluations sont réalisées sur des jeux de données privés, rédigés et corrigés par des experts sectoriels (droit, finance, code, multilinguisme, suivi d'instructions complexes), jamais publiés en clair.
- LiveBench : Un benchmark ouvert mais renouvelé en continu avec des questions basées sur des publications mathématiques, des articles scientifiques et des jeux de données parus très récemment, assortis d'une notation objective automatisée sans recours à un « LLM juge » biaisé.
6. Hugging Face Open LLM Leaderboard & LLM-Stats : comparer les modèles open-weight et les fenêtres de contexte
Pour les organisations qui souhaitent héberger leurs propres modèles ou utiliser des poids ouverts sur leur infrastructure cloud :
- Open LLM Leaderboard (Hugging Face) : Compare des milliers de variantes open-weight (familles Qwen, DeepSeek, Mistral, Llama, Gemma) et mesure l'impact de la quantification (FP16, FP8, INT4) sur la précision.
- Les agrégateurs multi-sources (LLM-Stats, BenchLM, Vellum) : Permettent de filtrer en un coup d'œil plus de 300 modèles en croisant simultanément la taille de la fenêtre de contexte, les tarifs d'API, les licences d'utilisation commerciale et les scores agrégés.
La méthode en 4 étapes pour choisir votre modèle sans vous tromper
Chez 21datas, nous recommandons de ne jamais choisir un modèle sur un seul classement, mais d'appliquer ce protocole rapide :
- Filtrer par faisabilité opérationnelle sur Artificial Analysis : Éliminez les modèles dont la latence (
TTFT), le débit ou le cost per task dépassent votre enveloppe budgétaire et vos contraintes de temps de réponse. - Vérifier la capacité de raisonnement pur sur LiveBench, Scale SEAL et SWE-bench : Retenez les 3 ou 4 modèles finalistes qui performent sur des tests non contaminés proches de votre cas d'usage (code, extraction, synthèse).
- Contrôler l'agrément utilisateur sur Arena.ai (avec Style Control activé) : Vérifiez que le modèle retenu produit des réponses naturelles et bien structurées en français et en anglais.
- Valider sur un mini-benchmark interne de 50 cas métiers : Avant la mise en production (par exemple dans 21brain), exécutez vos 3 finalistes sur 50 vraies questions de votre entreprise pour mesurer la précision réelle sur votre vocabulaire métier.
Besoin d'accompagnement pour sélectionner, tester et intégrer les meilleurs modèles IA dans votre architecture ? Prenez rendez-vous avec nos spécialistes ou contactez-nous.
in Data