Déployer un assistant analytique capable d'interroger à la fois des tables financières structurées, des contrats PDF et des modèles prédictifs sans sortir les données de l'entrepôt cloud est devenu l'objectif prioritaire des architectures modernes. Avec Snowflake Cortex — qui réunit Cortex Analyst, Cortex Search et l'API d'orchestration Cortex Agents — il est désormais possible de bâtir des agents IA directement adossés à la gouvernance RBAC de Snowflake.
Cependant, les retours d'expérience en production montrent une règle d'architecture incontournable : confier l'ensemble des tables et des documents de l'entreprise à un agent monolithique unique dégrade rapidement la précision. La solution consiste à découper le périmètre en agents spécialisés par domaine, coordonnés par un agent routeur au sein d'une application unifiée.
Étape 1 : configurer les briques d'agents spécialisés dans Snowflake Cortex
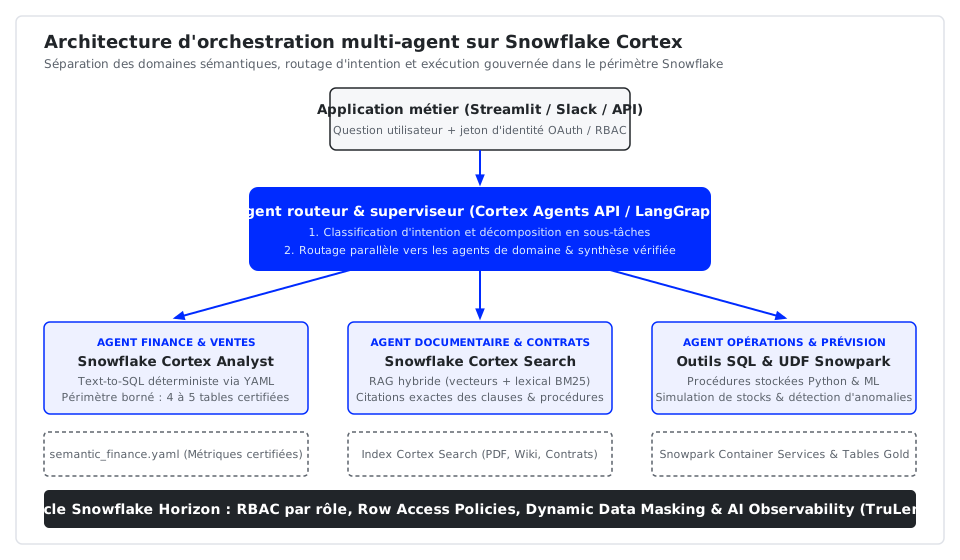
Une architecture agentique robuste sur Snowflake repose sur trois composants complémentaires, chacun confiné à un périmètre métier strict :
1. Cortex Analyst pour les données structurées (Text-to-SQL déterministe)
Au lieu d'exposer le schéma brut de centaines de tables SQL au LLM, Snowflake Cortex Analyst utilise un fichier de modèle sémantique déclaratif au format YAML stocké dans un stage Snowflake (@analytics_db.governance.semantic_models/finance_model.yaml). Ce fichier définit les tables certifiées, les dimensions, les synonymes métiers, les jointures autorisées et les formules exactes des indicateurs (par exemple l'ARR, la marge brute ou le DSO).
Les études d'industrialisation publiées par CloudEQS sur le passage à l'échelle de Cortex Analyst et par phData établissent une bonne pratique essentielle : limiter chaque vue sémantique à 4 ou 5 tables fortement cohésives. Au-delà de ce seuil, l'ambiguïté entre colonnes homonymes augmente le risque d'erreur de jointure.
2. Cortex Search pour les données non structurées (RAG hybride)
Pour interroger les bases documentaires (contrats fournisseurs, procédures qualité, tickets d'incidents), Cortex Search combine la recherche vectorielle dense et la recherche lexicale par mots-clés (BM25) avec ré-ordonnancement sémantique automatique. Sa mise en place s'effectue directement en SQL :
CREATE OR REPLACE CORTEX SEARCH SERVICE legal_db.contracts.contract_search_svc
  ON chunk_text
  ATTRIBUTES contract_id, supplier_name, jurisdiction, expiration_date
  WAREHOUSE = cortex_wh
  TARGET_LAG = '1 hour'
  AS (
    SELECT chunk_text, contract_id, supplier_name, jurisdiction, expiration_date
    FROM legal_db.contracts.parsed_contract_chunks
  );
3. Outils personnalisés via procédures stockées SQL et UDF Snowpark Python
Pour les actions métier ou les calculs statistiques avancés (prévision de rupture de stock, simulation tarifaire), chaque capacité est encapsulée dans une fonction ou procédure stockée typée, dotée d'une signature explicite que l'agent peut invoquer de manière déterministe.
Étape 2 : créer l'application avec un agent routeur qui orchestre tous les sous-agents
Plutôt que de laisser l'utilisateur choisir manuellement quel assistant interroger, l'application expose un point d'entrée unique piloté par un agent routeur (orchestrateur). En s'appuyant sur l'API Snowflake Cortex Agents, le Snowflake Labs Orchestration Framework ou un graphe superviseur LangGraph connecté à Snowflake, le routeur exécute quatre opérations :
- Analyse et décomposition d'intention : Si un directeur financier demande « Pourquoi notre marge nette en Suisse romande a-t-elle baissé au T3 et quelles clauses de révision tarifaire figurent dans nos contrats transporteurs ? », le routeur scinde la question en deux sous-requêtes indépendantes.
- Routage ciblé vers les agents spécialisés : La première sous-requête est transmise à l'
Agent Finance(branché surfinance_model.yamlvia Cortex Analyst), tandis que la seconde est envoyée en parallèle à l'Agent Juridique(branché surcontract_search_svcvia Cortex Search). - Exécution sous identité gouvernée : Chaque sous-agent s'exécute avec le rôle Snowflake (
SECONDARY ROLES/ RBAC) de l'utilisateur connecté, garantissant l'application stricte des Row Access Policies et du Dynamic Data Masking. - Synthèse et traçabilité : Le routeur agrège les résultats chiffrés issus du SQL généré et les extraits contractuels cités, puis restitue une réponse unifiée dans l'application (Streamlit in Snowflake, Slack ou interface web sur mesure comme 21brain).
# Exemple simplifié d'agent routeur orchestrant deux agents spécialisés Snowflake Cortex
from dataclasses import dataclass
import requests

AGENTS_CATALOG = {
    "finance_agent": {
        "type": "cortex_analyst_text_to_sql",
        "semantic_model": "@analytics_db.governance.models/finance_v2.yaml",
        "description": "Chiffre d'affaires, marges, facturation et trésorerie (4 tables certifiées).",
    },
    "legal_search_agent": {
        "type": "cortex_search",
        "service": "legal_db.contracts.contract_search_svc",
        "description": "Clauses contractuelles, SLA fournisseurs et conditions de révision tarifaire.",
    },
    "ops_forecast_agent": {
        "type": "sql_udf_tool",
        "procedure": "ops_db.ml.simulate_inventory_reorder",
        "description": "Simulation des stocks, délais d'approvisionnement et alertes logistiques.",
    },
}

def dispatch_with_router(user_query: str, selected_agents: list[str], snowflake_jwt: str, host: str):
    tools, tool_resources = [], {}
    for name in selected_agents:
        spec = AGENTS_CATALOG[name]
        tools.append({"tool_spec": {"type": spec["type"], "name": name}})
        if spec["type"] == "cortex_analyst_text_to_sql":
            tool_resources[name] = {"semantic_model_file": spec["semantic_model"]}
        elif spec["type"] == "cortex_search":
            tool_resources[name] = {"name": spec["service"], "max_results": 5}

    payload = {
        "model": "claude-sonnet-4-5",
        "messages": [{"role": "user", "content": [{"type": "text", "text": user_query}]}],
        "tools": tools,
        "tool_resources": tool_resources,
    }
    response = requests.post(
        f"https://{host}/api/v2/cortex/agent:run",
        headers={"Authorization": f"Bearer {snowflake_jwt}", "Content-Type": "application/json"},
        json=payload,
        timeout=60,
    )
    response.raise_for_status()
    return response.json()
Pourquoi une architecture multi-agent est nettement plus performante qu'un seul agent
L'intuition initiale consiste souvent à créer un « super-agent » unique doté d'une fenêtre de contexte de 200 000 ou 1 000 000 de tokens, auquel on attache 25 tables SQL et 15 outils métiers. Or, tant la recherche académique que les benchmarks industriels démontrent que le multi-agent spécialisé surpasse systématiquement l'agent monolithique dès que le système dépasse quelques tables.
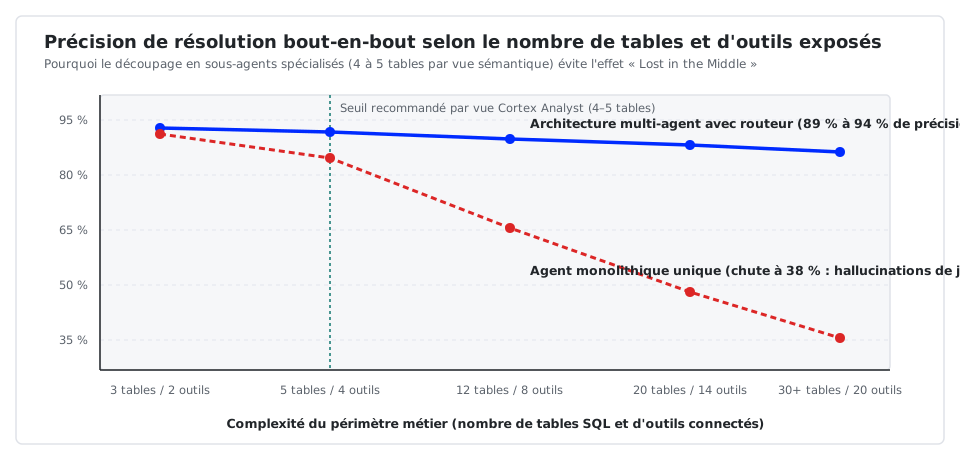
Voici les quatre preuves documentées qui expliquent cet écart de performance :
- Élimination du phénomène « Lost in the Middle » : L'étude de référence de l'Université de Stanford et UC Berkeley (Liu et al., Lost in the Middle: How Language Models Use Long Contexts, TACL) démontre que la capacité de rappel et de raisonnement d'un LLM chute fortement lorsque l'information pertinente est noyée au milieu d'un long contexte de schémas et d'instructions. En isolant chaque sous-agent sur un modèle sémantique court (4 à 5 tables), le contexte reste dense et pertinent.
- Réduction de la confusion de sélection d'outils (
tool selection degradation) : Les analyses d'architecture publiées par phData sur Snowflake Cortex Agents et les guides Snowflake & LangGraph montrent qu'au-delà de 6 à 8 outils similaires dans un même prompt, le taux d'hallucination de paramètres et de mauvaise sélection d'outil augmente rapidement. Le pattern hub-and-spoke (un routeur + des spécialistes) ramène la précision de routage au-dessus de 90 %. - Parallélisation et réduction de la latence et des coûts : Le routeur n'envoie le schéma financier qu'à l'agent financier et l'index documentaire qu'à l'agent juridique. Le volume total de tokens d'entrée par requête est divisé par trois ou quatre, et les sous-agents s'exécutent en parallèle.
- Cloisonnement sécuritaire (principe du moindre privilège) et auditabilité : Chaque sous-agent dispose uniquement des droits d'accès correspondant à son domaine métier. Les traces d'exécution (évaluables avec Snowflake AI Observability / TruLens) permettent d'auditer séparément la qualité du routage, la fidélité du SQL généré et l'ancrage factuel de la synthèse finale.
Sources et références techniques
- Snowflake Documentation — Cortex Agents & Orchestration API
- Snowflake Documentation — Cortex Analyst Semantic Model Specification
- Snowflake Labs — Multi-Agent Orchestration Framework (GitHub)
- Snowflake Developers Guide — Build and Evaluate Multi-Agent Systems with Snowflake and LangGraph
- phData — Snowflake Cortex Agents: Governed Multi-Agent Architecture Guide
- CloudEQS — How to Scale AI Agents with Snowflake Cortex Analyst
- Liu et al. (Stanford / UC Berkeley) — Lost in the Middle: How Language Models Use Long Contexts
En tant que partenaire spécialisé sur les architectures Snowflake et AI Engineering en Suisse, 21datas conçoit et déploie vos couches sémantiques Cortex et vos orchestrateurs multi-agents. Contactez notre équipe ou planifiez un échange technique pour cadrer votre projet.
in Data